 真实页面
用一句话「设计」一个声音
- 在哪
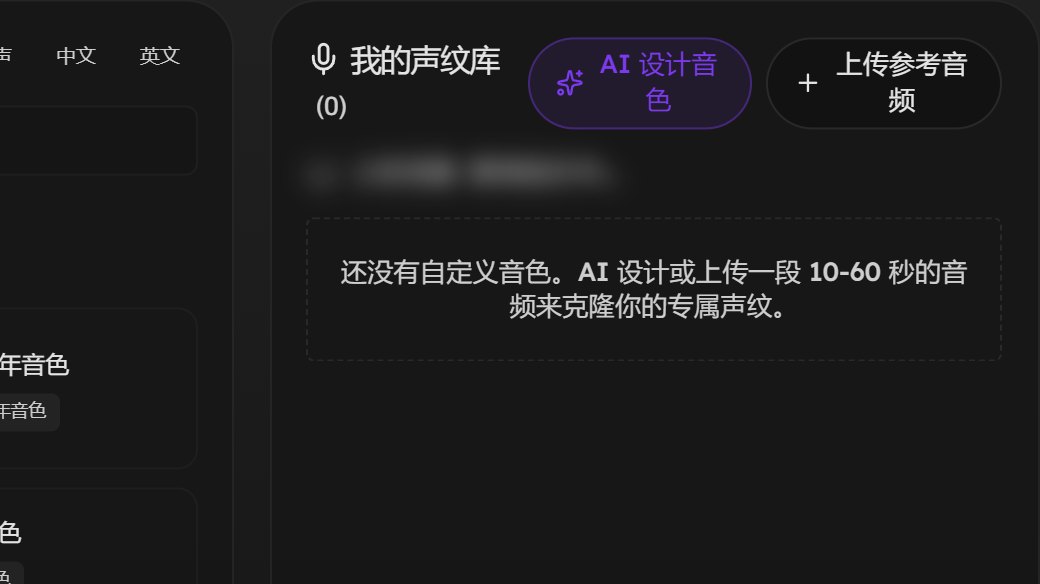
- 海螺的音色库右边「AI 设计音色」
- 点了之后
- 写一句想要的声音,比如「讲悬疑故事的播音员,声音低沉」,生成一个专属声音,存进「我的声纹库」。生成时会扣一次钱
- 不知道的话
- 以为只能在现成的几百个声音里挑,或者只能克隆自己
写一段文字,选一个声音,点一下发送就能听到它念出来。学会之后,还能用自己的声音念,或者做一首歌。
 真实生成的配音
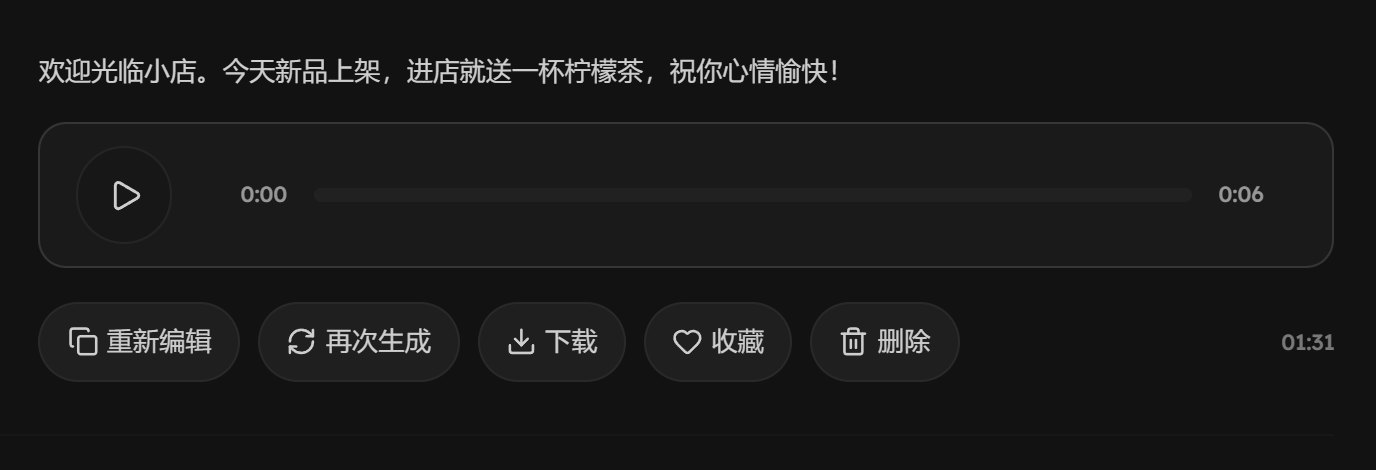
欢迎光临小店。今天新品上架,进店就送一杯柠檬茶,祝你心情愉快!
就是把上面这句话交给网站上的语音模型念出来的 6 秒配音,从点发送到能听,等了不到半分钟。在网站上点播放就能听。
音频下面有好几个模型,各管一件事。不用记名字,先选你想做的:
念中文最自然,能挑的声音最多(几百个),还能换成你自己的声音。不知道选哪个就选它。
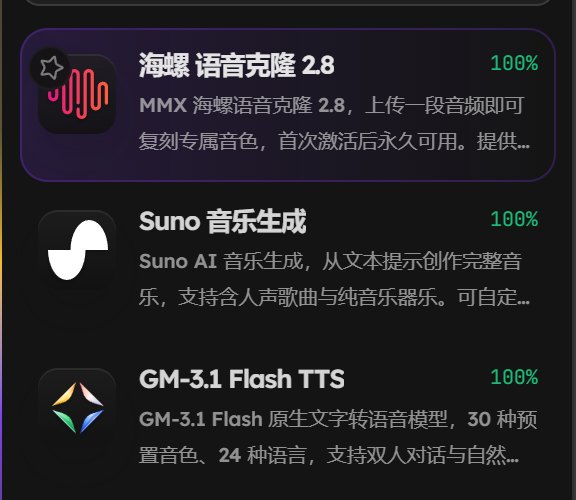
左侧栏「音频」列表里点「海螺 语音克隆 2.8」。
 真实页面
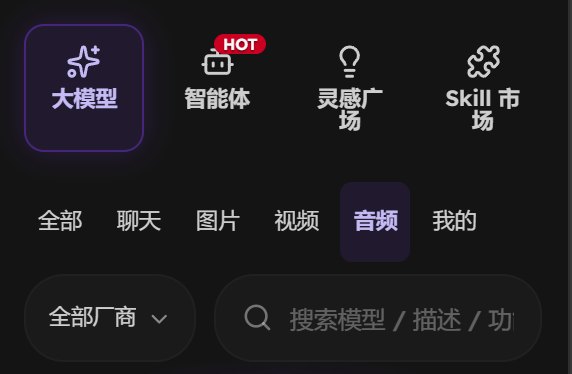
页面左侧栏默认停在 大模型。点它下面那一排里的 音频。
你会看到:下面的列表只剩能做声音的模型。
 真实页面
在列表里点 海螺 语音克隆 2.8。念中文用它最稳;想做别的,回上一节看该选哪个。
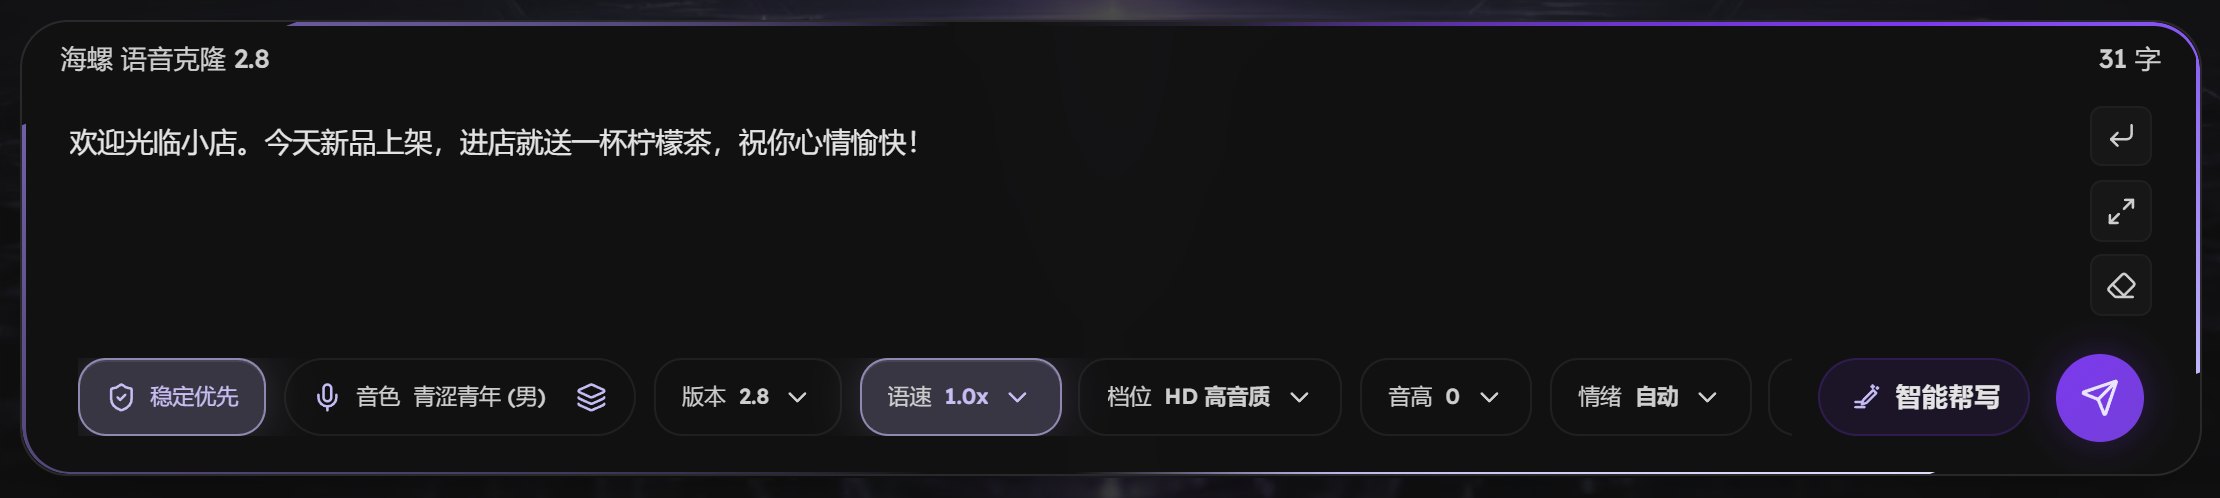
你会看到:进入音频页面,下方是输入框,框下面一排是音色、语速这些设置。
 真实页面
在输入框里输入或粘贴要念的内容,比如:
欢迎光临小店。今天新品上架,进店就送一杯柠檬茶,祝你心情愉快!
它会照着原文念,不会帮你改写。按回车只会换行,不会发出去。第一次先写一两句,声音听着合适了再贴整篇。
 真实页面
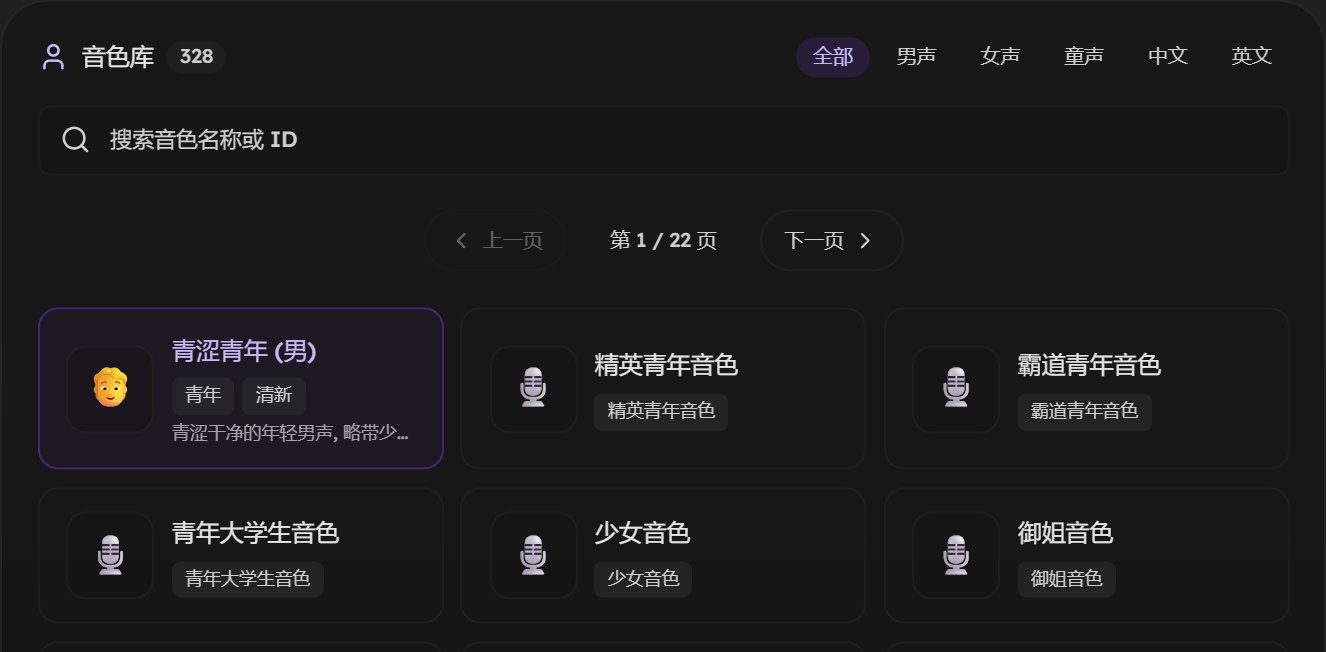
点输入框下方的 音色,打开音色库。上面可以按 男声 女声 童声 筛选。卡片右边有播放按钮的,点它先听一下,合适就点卡片选中,再点右上角关掉。
试听不花钱,听的是提前录好的样音。不是每个音色都有样音,没有播放按钮的,就先用一两句话试念。
真实页面输入框下面的 语速 档位 音高 情绪 这些,第一次都保持默认。然后点右下角紫色的发送按钮(纸飞机图标)。
你会看到:输入框清空,上方出现一张新卡片开始转圈,转完就能听。别重复点发送,每点一次都是一段新的,各扣一次钱。
 真实页面
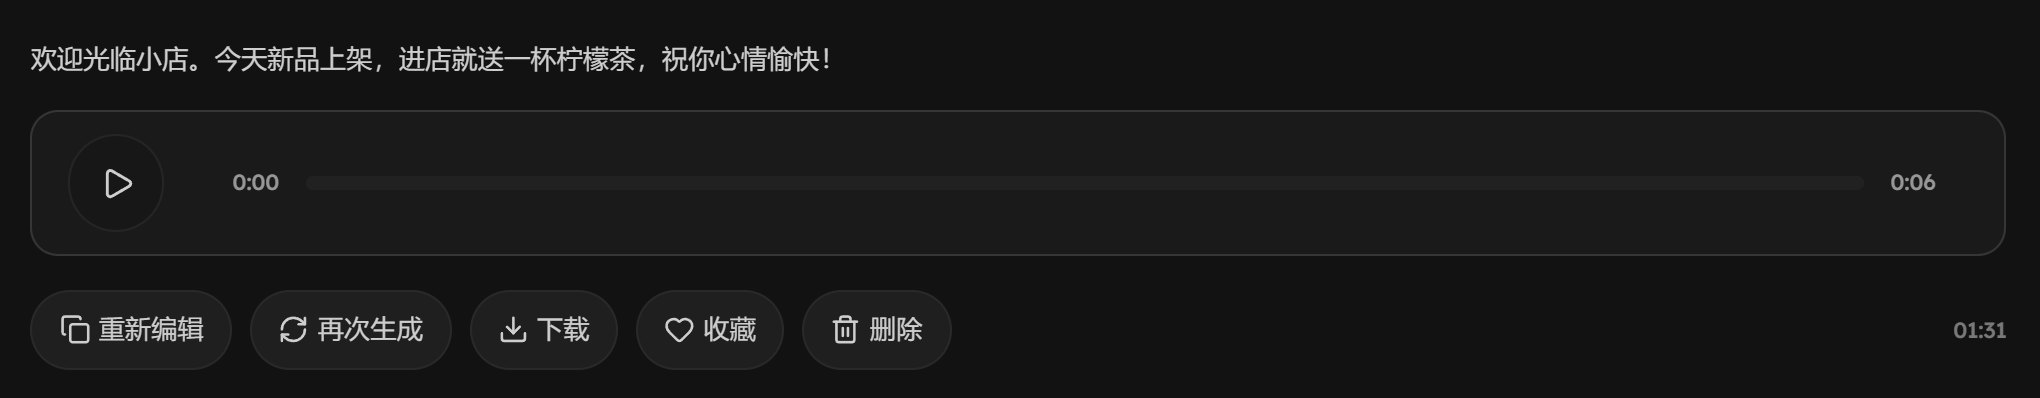
点播放条左边的按钮就能听。满意就点 下载,存成音频文件。
不满意想换个声音再念?点 再次生成:它只把文字填回输入框,不会马上开始,换好音色再点一次发送(会再扣一次钱)。到这一步,你已经会用了。
只有「海螺 语音克隆 2.8」能做。克隆一次要花钱,先把录音准备好再开始。
用手机录 10 到 60 秒,找个安静的地方,正常说话就行,不要背景音乐,只有你一个人的声音。
录得越清楚,克隆出来越像。只克隆你自己的,或者已经得到本人同意的声音。
 真实页面
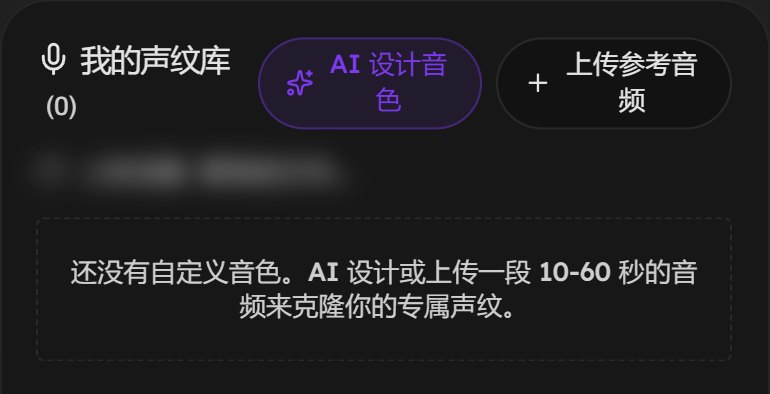
确认左侧栏选的是 海螺 语音克隆 2.8。点输入框下方的 音色,在音色库右边「我的声纹库」里点 上传参考音频,选你刚才的录音。
看不到「我的声纹库」这一栏?说明当前选的不是海螺,其它模型不能克隆。
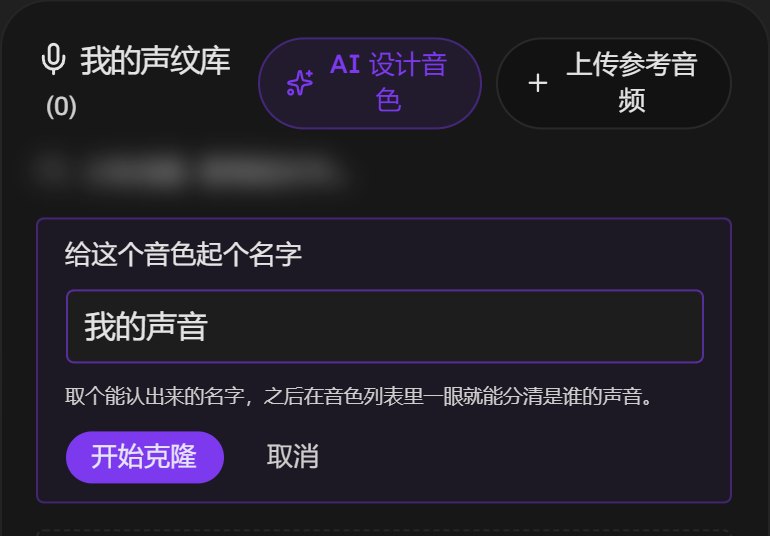 真实页面
给这个声音起个认得出来的名字,比如「我的声音」。然后点 开始克隆。
点「开始克隆」才会扣钱,扣多少在这一栏上方写着。按钮转圈时等它完成,好了会自动选中这个声音,出现在「我的声纹库」里,以后直接点它就能用。
关掉音色库,输入框下方的 音色 显示的就是你的声音。像上一节一样写文字、点发送。
克隆的声音只能在「海螺 语音克隆 2.8」里用,换到别的模型选不到它。
选「Suno 音乐生成」后,输入区会变成上下两个框。两步:
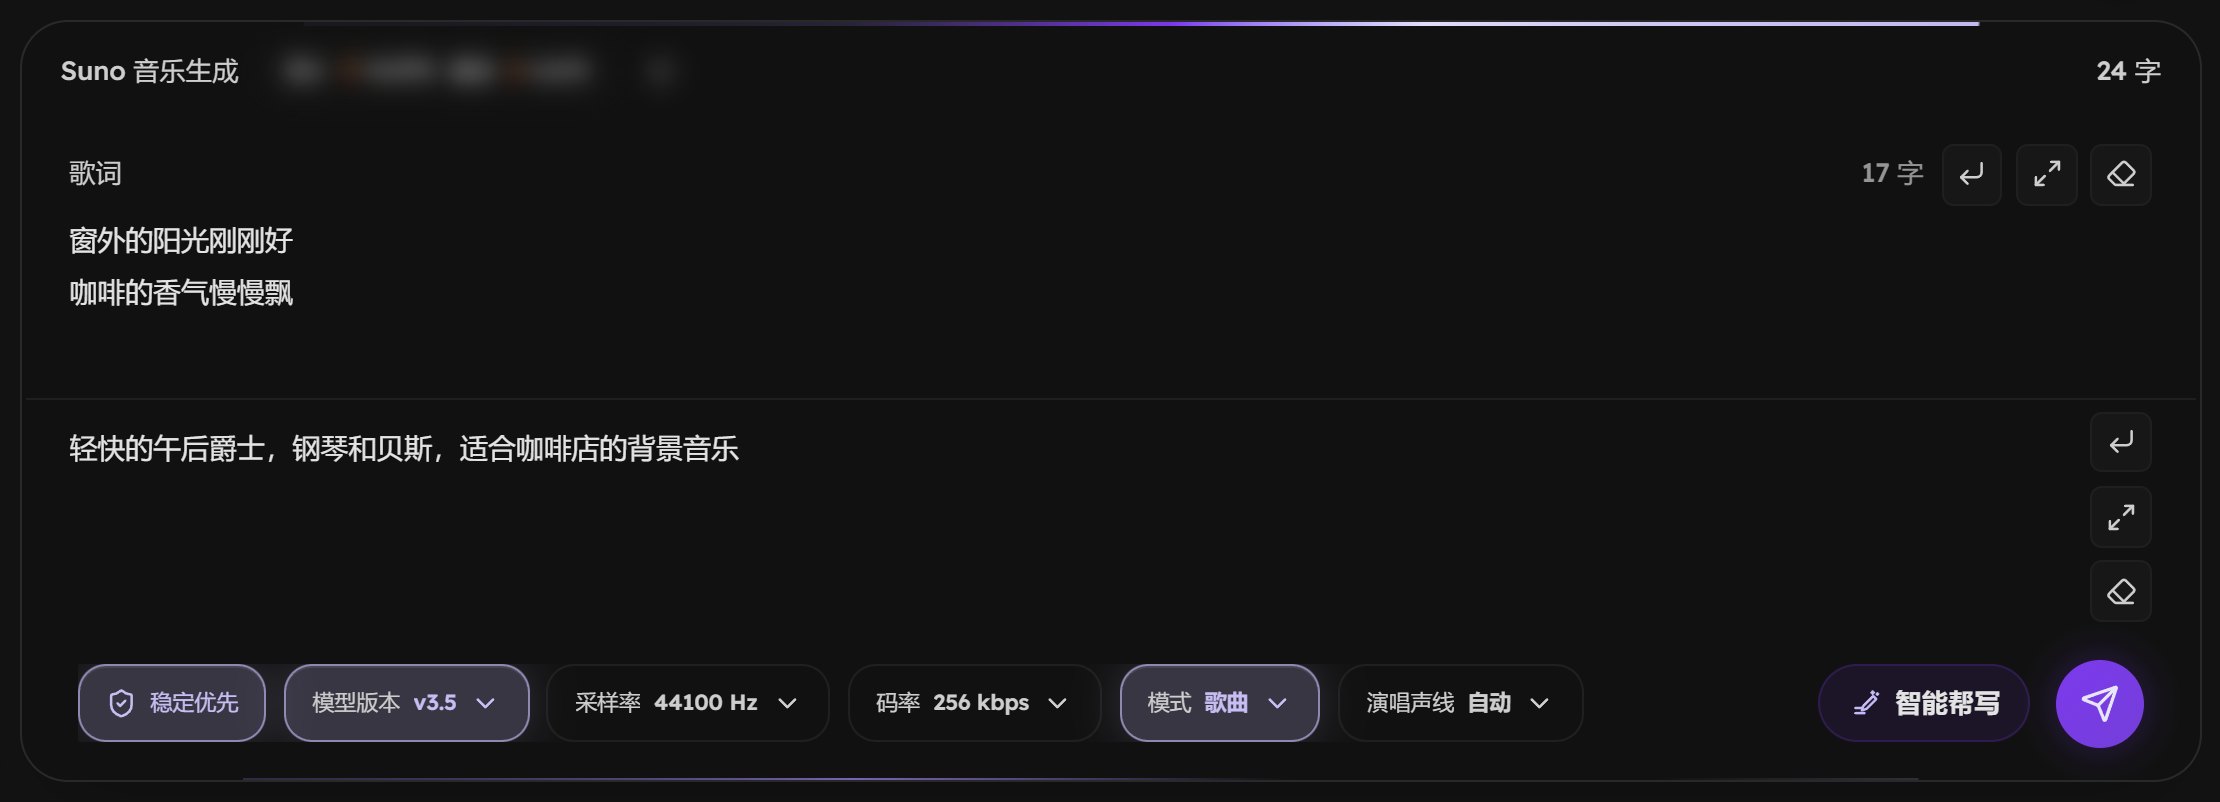 真实页面
上面的 歌词 框写歌词,一行一句。下面的框写什么风格、用什么乐器、什么气氛、快还是慢,比如:
轻快的午后爵士,钢琴和贝斯,适合咖啡店的背景音乐
两个框别写反:歌词框里页面也提示着「曲风、乐器、氛围和节奏在下方提示词框中描述」。
真实页面最下一排的 模式:要人声唱就选 歌曲,只要伴奏就选 纯音乐。其它设置先别动,点发送。
做歌比念文字贵得多,别连着点发送,每点一次都是一首新歌、各扣一次钱。
这三个平时不起眼,不留心根本注意不到。
真实页面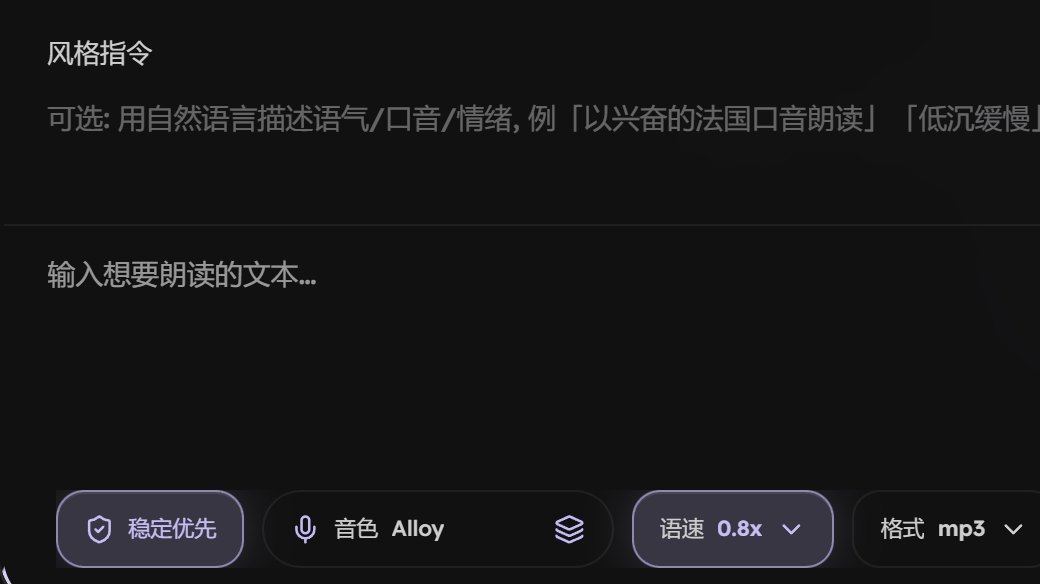 真实页面
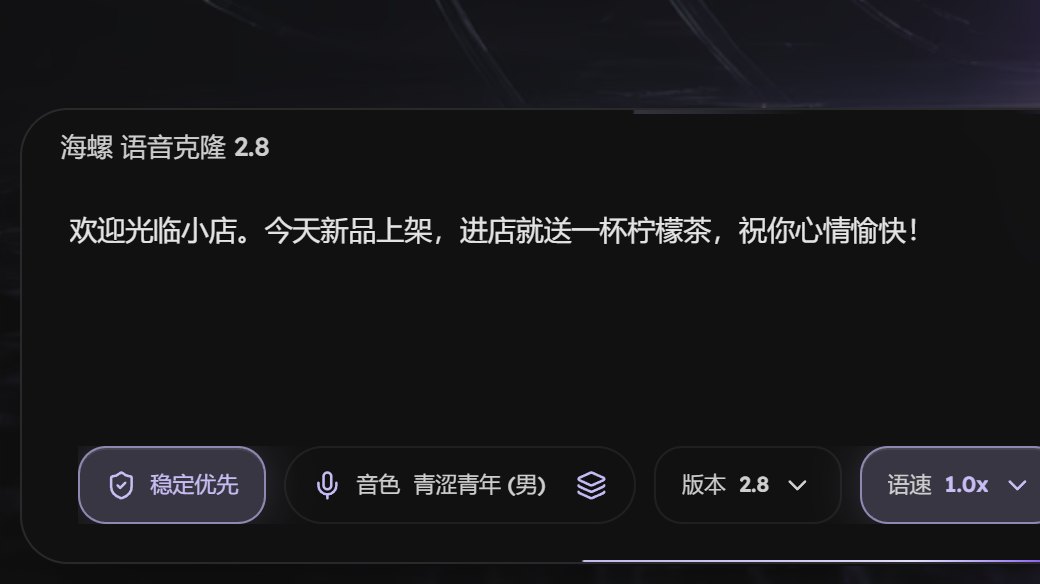 真实页面
输入框上方的「预计」是发送前的大概价钱,只是参考:念一大段文字时,实际扣的可能比它多。做完后以结果卡上写的为准,也可以去消费记录里查。
不同模型、不同声音价格差得很多。第一次先用一两句话试,声音对了再贴整篇。
「GM-3.1 Flash TTS」「GM-2.5 Pro TTS」只念英文等外语。
中文请换「海螺 语音克隆 2.8」,文字留在输入框里不用重写。
只有「海螺 语音克隆 2.8」能克隆。先在左侧栏换成它,再打开音色库。
克隆的声音只能在海螺里用。切回「海螺 语音克隆 2.8」就能看到。
它只是把文字填回输入框,要再点一次发送才会生成,也会再扣一次钱。
没丢。音频页只显示当前模型做的,切回原来那个模型就能看到。
设置会记住你上次发送时的选择。看看输入框下面的「语速」,改回 1.0x。
这一课学完了吗?
下一课:算力与计费